很多企业在部署远程办公VPN、门店组网VPN的时候,往往会直接把产品宣传页标注的VPN并发连接数量当成选型的核心依据,但是实际上线之后经常出现远达不到标称值就出现隧道卡顿、新连接无法接入的问题,本质原因是不同产品的并发数测试环境、统计口径差异极大,对比过程中只有记录全维度的关键参考信息,才能得到符合自身实际使用场景的有效结论。
VPN服务端的原生配置基线
很多人对比的时候只抄产品页写的并发数,但是忽略服务端本身的承载配置,比如是跑在通用x86服务器上还是专用VPN硬件网关,不同的底层硬件的转发能力上限本来就不一样,同一款VPN软件装在不同配置的服务器上,实际能跑的并发连接数差异很大,脱离硬件配置谈标称并发数没有任何实际参考意义。
要记录服务端启用的附加功能清单,比如是否开了流量审计、入侵检测、数据分片加密这些额外模块,每多开一个占用算力的功能,能承载的有效并发连接数就会和裸跑转发的测试值不一样,很多厂商的标称值都是关闭所有附加功能的理想环境下测出来的,实际部署开了功能之后数值会出现明显缩水。
并发连接的定义口径对齐记录
很多人容易踩的坑是不同厂商对VPN并发连接数量的定义完全不一样,有的厂商把每一个TCP会话就算一个并发连接,有的是把每一个接入的终端设备算一个并发连接,一台设备开10个网页走VPN隧道在后者的统计里只算1个,前者就算10个,不对齐口径的对比完全没有参考价值。
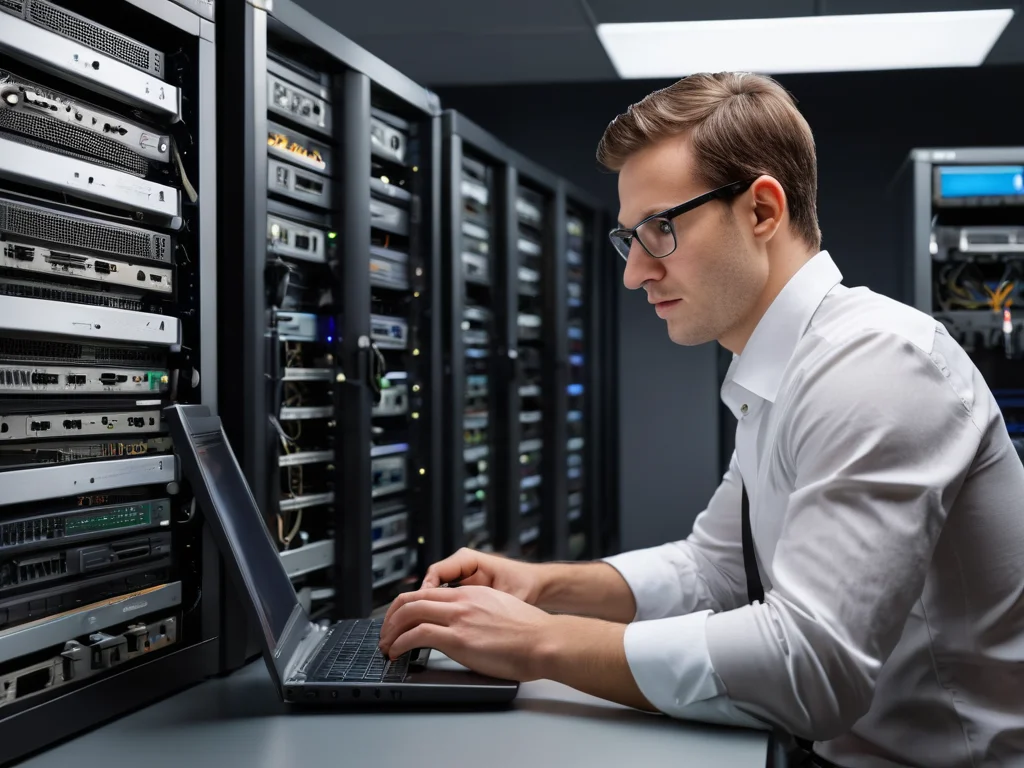
运维人员核查VPN服务端硬件配置与功能状态,确认真实可承载的并发连接上限
还要记录测试场景下的连接类型占比,比如是远程桌面类的长连接多,还是网页浏览类的短连接多,短连接的创建销毁频率很高,同样的硬件环境下,能承载的短连接数量远高于稳定在线的长连接数量,对比的时候要把两类连接的比例固定下来,不然得出的结果没有可比性。
还要区分并发连接的统计维度是在线峰值还是每秒新建数,很多测试报告里会把每秒新建连接的数值当成可稳定承载的并发在线数,实际跑业务的时候很容易出现隧道频繁断开重连的问题,记录的时候要明确标注两个数值的分别统计结果,避免后续上线出现预期偏差。
客户端侧的实际运行环境参数
要记录接入终端的系统版本和VPN客户端的类型,比如是用系统自带的原生VPN客户端,还是厂商定制的专用客户端,部分老旧的桌面系统版本自带的VPN模块存在兼容性bug,樱花连接数上去之后会出现大量半开连接占满服务端资源,拉低整体的有效并发承载量。
还要记录客户端侧的网络接入链路属性,比如所有测试终端都是用有线内网接入VPN网关,还是混合了移动网络、家用宽带、跨运营商专线的不同链路,网络加速器公网链路的波动会导致部分连接异常断开之后还在服务端残留会话,占用正常的并发名额,统计的时候要把残留会话的数量单独摘出来,不要算进有效并发的数值里。
异常场景下的边界故障记录
对比不同VPN的并发承载能力的时候,不能只记稳定运行的正常数值,还要记录并发数触达上限之后的具体表现,是新连接直接被拒绝,还是老连接随机被踢下线,还是整体隧道的转发延迟飙升,网络加速器不同的表现对应后续业务场景里的容错能力差异很大,适配不同的业务容错要求。
还要记录并发数过载之后的恢复行为,比如把接入终端数量降到标称值以下之后,樱花VPN服务端能不能自动清理残留会话恢复正常转发,还是需要手动重启服务才能恢复,这类信息在厂商的公开参数里基本不会标注,只有实际测试记录才能拿到,也会直接影响后续运维的工作量。
最后还要同步记录测试过程中后台的资源占用数据,包括服务端的CPU使用率、内存占用、带宽利用率的实时数值,排除因为硬件本身资源耗尽导致的并发数上限,确保最终对比得到的VPN并发连接数量差异,是来自产品本身的转发优化能力,而不是硬件资源不足带来的误差。